Prérequis
Tout ce qui doit être réuni ou réservé avant de commencer une installation. Rien de cette
page ne se substitue à scripts/preflight.sh, qui vérifie mécaniquement une partie de ces
prérequis : cette page dit ce qu'il faut réunir, le script dit si c'est effectivement réuni.
Matériel et hyperviseur
Le cluster de référence tient sur six machines virtuelles, sous un hyperviseur (VMware ESXi sur l'instance de référence) : trois noeuds control-plane, trois noeuds worker, Talos v1.13.
Ce nombre est un dimensionnement de référence, pas une contrainte du guide : un client peut en
poser plus ou moins. Il se déclare dans la fiche par TV_NODE_COUNT, que
scripts/validate-install.sh compare au nombre de noeuds réellement Ready
(Paramètres).
- Extensions Talos : les workers embarquent l'extension
iscsi-tools(module noyauiscsi_tcp), requise par Longhorn pour le stockage bloc répliqué. Elle ne se déclare pas dans la configuration : elle est cuite dans l'image d'installation par l'Image Factory de Talos (https://factory.talos.dev, cochersiderolabs/iscsi-tools), etinstall.imagedu profil worker pointe sur l'installeur de ce schematic. C'est cette image qui sert aussi aux montées de version ; un installeur générique à la place ferait perdre iSCSI au premiertalosctl upgrade. - Disques : deux disques par worker. Le
install.diskdu profil worker désigne le disque système de la VM cliente. Le second est dédié à Longhorn :talos/patches/longhorn-disk.yamly déclare un volume utilisateur, formaté et monté par Talos en/var/mnt/longhornsans redémarrage, que le profil worker expose au kubelet. Sans second disque, Longhorn tombe sur la partition éphémère, partagée avec les images et les journaux, et l'espace libre des deux se confond. - StorageClass : le cluster doit exposer une StorageClass par défaut bien avant la couche
applicative. C'est Vault, posé dès la couche de base, qui la réclame en premier : ses trois
pods restent
Pendingtant qu'elle manque, et toute la suite de la procédure attend avec eux.scripts/preflight.shle vérifie à son contrôle 7, mais seulement lancé sans--skip-cluster, donc à l'étape 4 du Pas-à-pas et pas avant. La valeur attendue est portée parTV_STORAGE_CLASSdans la fiche client. - Ressources par noeud (CPU, RAM) : ce dépôt ne fixe pas de valeur minimale validée. En attendant qu'un dimensionnement de référence existe, demander une recommandation à l'éditeur avant de commander le matériel, et relever la consommation réelle après le premier déploiement pour affiner les commandes suivantes.
Point de panne unique sur un seul hôte physique
La redondance de trois control-plane plus trois workers protège d'une panne logicielle ou du redémarrage d'une VM, pas de la perte de l'hôte, de son alimentation ou de son datastore : sur un seul serveur, cette perte emporte le cluster et la couche de données ensemble. Une VM de données séparée sur ce même hôte n'améliore pas la disponibilité, elle améliore l'exploitabilité, ce qui est un gain réel mais différent. La seule mesure qui supprime ce point de panne est un second hôte physique pour les VM de données. Avant même ce choix de placement, une sauvegarde qui sort de cet hôte passe devant : ce guide n'en fournit aucune.
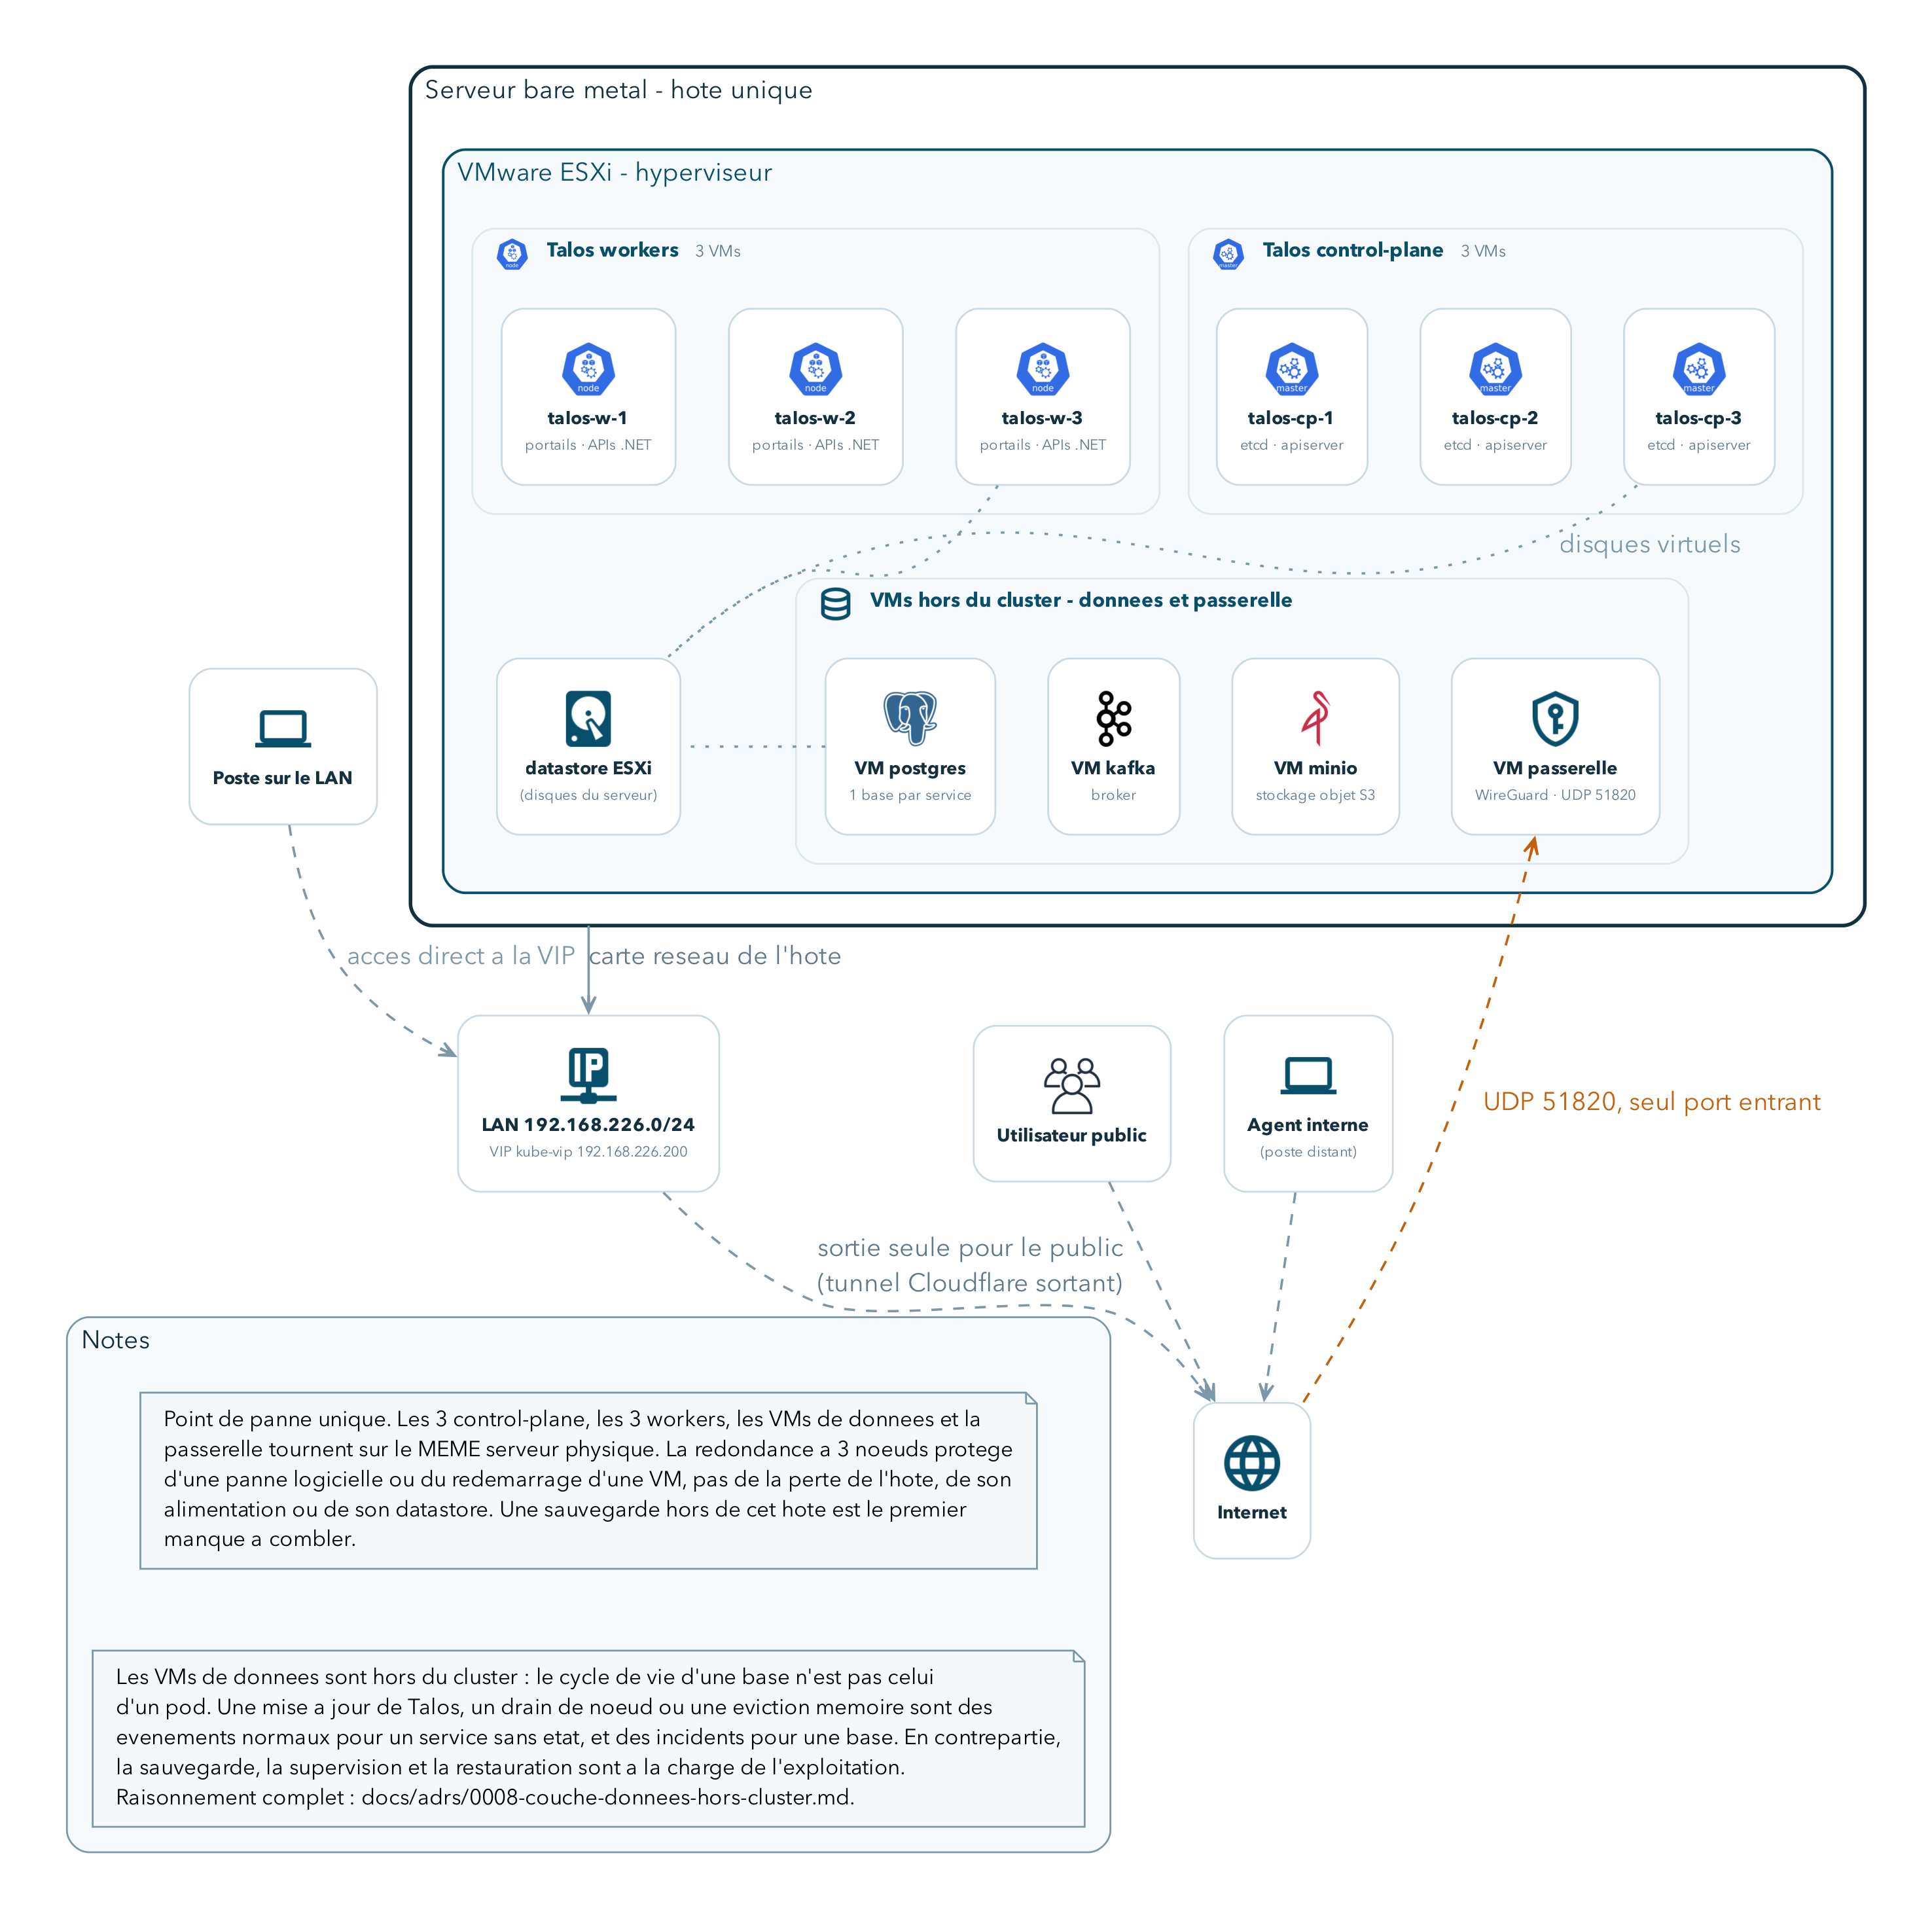
Tout ce que montre cette figure tient sur une seule machine physique. C'est la ce qu'il faut y voir : les six VM Talos et les VM de donnees partagent le meme serveur, la meme alimentation et le meme datastore.
Plan d'adressage à réserver
Six adresses ou plages à réserver avant de commencer, indépendantes du domaine. Les valeurs
ci-dessous sont un exemple illustratif, au même format que celles de
scripts/install.env.example, jamais une valeur à recopier telle quelle.
| Variable | Rôle | Exemple illustratif |
|---|---|---|
${TV_CP_ENDPOINT} |
endpoint du control-plane Talos, consommé par talosctl |
10.0.0.100 |
${TV_VIP} |
adresse virtuelle publiée par kube-vip, point d'entrée unique du cluster | 10.0.0.200 |
${TV_VIP_RANGE} |
plage gérée par kube-vip, VIP comprise, au moins dix adresses contigües | 10.0.0.200-10.0.0.209 |
${TV_TRAEFIK_CLUSTERIP} |
ClusterIP fixe du service Traefik, référencée par CoreDNS | 10.111.0.21 |
${TV_POD_SUBNET} |
sous-réseau des pods, consommé par talosctl |
10.244.0.0/16 |
${TV_SVC_SUBNET} |
sous-réseau des services, consommé par talosctl |
10.96.0.0/12 |
${TV_CP_ENDPOINT} vit dans la configuration Talos et est hors de la portée de
scripts/render-config.sh : il se fixe à la génération de la configuration machine, pas par
substitution de texte. ${TV_POD_SUBNET} et ${TV_SVC_SUBNET} vivent eux aussi dans cette
configuration, mais pas seulement : render-config.sh les substitue également dans
core/vpn/peer-officer.template.conf, où le tunnel annonce ces deux plages aux agents. Les
changer dans Talos sans les reporter dans la fiche laisse le tunnel monter, les agents se
connecter, et ne rien joindre derrière, sans aucune erreur.
Zone DNS et compte Cloudflare
- Un domaine dédié au client,
${TV_DOMAIN}, déjà délégué à Cloudflare avant de commencer. - Un compte Cloudflare avec accès à la zone de ce domaine, et son identifiant de zone,
${TV_CF_ZONE_ID}. - Un jeton API scopé à cette seule zone, avec deux permissions et rien de plus :
Zone:DNS:Edit, qui écrit les enregistrements_acme-challengedu challenge DNS-01, etZone:Zone:Read, que le contrôle 5 descripts/preflight.shexige parce qu'il interrogeGET /zones/${TV_CF_ZONE_ID}. C'est ce jeton quescripts/preflight.shvérifie via la variable d'environnementCF_API_TOKEN. Un jeton limité àZone:DNS:Editfait rendre unKO zone <id> : HTTP 403à ce contrôle : le message nomme la portée incomplète en première cause, puis la zone et la révocation, et donne la requête/user/tokens/verifyqui les sépare.
L'émission des certificats se fait par challenge DNS-01 plutôt que HTTP-01 : HTTP-01 interdit les wildcards et exigerait d'exposer publiquement chaque host, l'inverse du modèle d'exposition de cette plateforme.
Trois contraintes de niveau prérequis en découlent, à valider avant de commencer :
- La résolution DNS interne du cluster réécrit tout
*.${TV_DOMAIN},_acme-challengecompris. La vérification de propagation que cert-manager exécute avant de demander la validation ne peut donc jamais aboutir si elle passe par le résolveur du cluster. - cert-manager doit par conséquent tourner avec
--dns01-recursive-nameservers-onlyet--dns01-recursive-nameservers=1.1.1.1:53,8.8.8.8:53, ce qui suppose que les noeuds joignent ces deux résolveurs en sortant sur le port 53. C'est une ouverture réseau à faire valider auprès du client, au même titre que le plan d'adressage. - Ce réglage ne vit pas dans les manifestes amont de cert-manager : toute réinstallation ou mise à jour qui réapplique son Deployment l'efface silencieusement, et la panne n'apparaît qu'au renouvellement suivant, jusqu'à soixante jours plus tard.
Domaine .app et HSTS preload : pas de contournement possible
Si ${TV_DOMAIN} se termine en .app, le domaine est sur la liste HSTS preload des
navigateurs. Tant que le certificat wildcard n'est pas émis et Ready, aucun host de la
plateforme n'est joignable, et le navigateur n'offre aucun moyen de passer outre : le
bouton « continuer malgré tout » n'existe pas sur ce type de domaine. Vérifier avant de
commencer que la zone Cloudflare est bien déléguée pour ce domaine.
Couche de données externe
La fiche client déclare six endpoints de données externes, et scripts/preflight.sh refuse
de passer tant qu'ils ne répondent pas : c'est une contrainte des scripts de ce guide, à
provisionner et à rendre joignables depuis le cluster avant l'installation.
État réel du dépôt, que l'opérateur qui provisionne ces six services doit connaître. Kafka,
Redis et Elasticsearch sont déployés dans le cluster par la couche de base du dépôt
(data/kafka.yaml, data/redis.yaml, data/elasticsearch.yaml), pas hors cluster, et aucun
service ne se connecte aux deux derniers : ces deux endpoints n'apportent aujourd'hui aucune
fonction. Ils restent pourtant à provisionner, car preflight.sh les teste comme les quatre
autres et refuse de passer si l'un d'eux ne répond pas. Les fournir est donc obligatoire pour
installer, sans être utile à l'exécution.
Un septième endpoint, absent de cette liste comme de la fiche client, est en revanche
indispensable : la base de données de Keycloak. Aucun manifeste de ce dépôt ne la déploie.
apps/keycloak/keycloak.yaml code en dur
jdbc:postgresql://keycloak-db-rw:5432/app, et aucun manifeste ne crée le Service
keycloak-db-rw. Une base Postgres joignable sous ce nom exact et ce port est donc à
provisionner comme les six autres, sans qu'aucune variable de la fiche ni aucun contrôle de
preflight.sh ne la réclame ni ne la vérifie. Le détail est à l'étape 11 du
Pas-à-pas.
| Variable | Sert à | Symptôme si fausse |
|---|---|---|
${TV_PG_HOST} |
Postgres applicatif | pods .NET en redémarrage en boucle, sans message explicite côté Kubernetes |
${TV_KAFKA_BOOTSTRAP} |
non consommé : Kafka est déployé dans le cluster par la couche de base | sans effet, variable exigée par preflight.sh |
${TV_REDIS_HOST} |
non consommé : aucun service ne s'y connecte, et un Redis est déjà déployé dans le cluster par la couche de base | sans effet, variable exigée par preflight.sh |
${TV_ES_HOST} |
non consommé : aucun service ne s'y connecte, et un Elasticsearch est déjà déployé dans le cluster par la couche de base | sans effet, variable exigée par preflight.sh |
${TV_MINIO_ENDPOINT} |
stockage objet des médias du content-service | images cassées en 403 |
${TV_SMTP_HOST} |
SMTP réel du client | aucun mail de la plateforme ne part, sans erreur côté application |
scripts/preflight.sh vérifie une ouverture TCP (nc -z) sur chacun de ces six endpoints :
cela prouve que le port répond, pas que les identifiants sont bons ni que la base ou l'index
attendu existe.
Deux contraintes d'exploitation à trancher au provisionnement, pas après : ne jamais poser
les données MinIO et le PGDATA sur le même disque virtuel, sur des datastores distincts si
l'hôte le permet ; les sauvegardes, la surveillance et la restauration des VM de données sont
à la charge de l'opérateur, ce guide n'en fournit aucune.
Ces valeurs s'écrivent dans Vault au pas-à-pas de l'installation, pas dans les manifests.
Outils du poste opérateur
Vérifiés mécaniquement par scripts/preflight.sh, section « outils du poste ».
| Outil | Sert à |
|---|---|
kubectl |
piloter le cluster une fois amorcé |
kustomize |
construire ou valider localement la couche de base (kustomize build .), en plus de l'intégration kustomize propre à kubectl |
talosctl |
générer la configuration machine, amorcer le cluster ; à faire correspondre à la version de Talos installée |
curl |
vérification du jeton Cloudflare, appels API ponctuels |
sed, grep |
utilisés par render-config.sh et par les scripts du guide |
nc |
vérification de la joignabilité de la couche de données (section « 8. couche de donnees » de preflight.sh) |
dig |
vérification que les hosts internes ne sont pas résolus publiquement, seul garde-fou automatique du cloisonnement public/interne (contrôle 8 de scripts/validate-install.sh) |
jq |
lister les clés d'un chemin Vault sans afficher les valeurs (page Configuration) |
Ce dépôt ne fixe pas de version minimale pour ces outils au-delà de leur compatibilité avec
Talos v1.13 et la version de Kubernetes du cluster cible : faire correspondre talosctl et
kubectl à ces deux versions avant de commencer, à défaut d'autre repère validé.
Comptes et accès à obtenir avant de commencer
- Accès hyperviseur (ou physique) au matériel cible, suffisant pour créer les six machines virtuelles.
- Accès
talosctl: possibilité de générer un jeu de secrets Talos propre à cette instance (jamais de réutilisation de secrets d'une autre instance). - Compte Cloudflare sur
${TV_DOMAIN}, avec le jeton et l'identifiant de zone du paragraphe précédent. - Accès réseau et identifiants à chacun des six services de la couche de données externe.
- Accès au dépôt
trade.infrapour cloner le guide et les scripts. - Sortie HTTPS sur le port 443, depuis le poste opérateur et depuis les six noeuds, vers
github.com,charts.longhorn.io,charts.external-secrets.io, le registre${TV_REGISTRY}et les registres publics des images amont (Talos, Calico, Traefik, Vault, kube-vip, cert-manager, metrics-server, Longhorn). Aucun contrôle depreflight.shne teste cette sortie : sur un réseau filtré, le manque n'apparaît qu'à l'étape 3 du Pas-à-pas, « Poser la couche de base », en pods bloqués enImagePullBackOff, c'est-à-dire pendant la fenêtre d'intervention. Cette ouverture se fait valider avec le client au même titre que le port 53 sortant et que le plan d'adressage.
Vérifier
Toutes les commandes de ce guide, celles de cette page comme celles des suivantes, s'exécutent
depuis la racine d'une copie du dépôt trade.infra. Cette copie n'est pas dans
l'archive : elle s'obtient auprès de l'éditeur, qui fournit l'URL du dépôt, l'accès en lecture
et la référence que ce guide décrit
(Vue d'ensemble).
git clone <url-du-depot-fournie-par-lediteur> trade.infra
cd trade.infra
git checkout <reference-fournie-par-lediteur>
git rev-parse --short HEAD
La dernière ligne affiche la référence réellement obtenue : elle doit être celle que l'éditeur a remise avec cette archive. Si elle diffère, s'arrêter ici et demander la version du guide qui correspond : les comptes que les pages suivantes affirment sur le dépôt ne valent que pour la référence décrite. Le répertoire courant reste cette racine jusqu'à la fin de l'installation.
La fiche se remplit à la page 03 : cette copie donne seulement un fichier à lire à la
commande suivante. Tant que la fiche n'est pas remplie, ${TV_DOMAIN} reste exemple.tld
et le contrôle 3 la refuse, ce qui est attendu à ce stade.
Le cluster n'existe pas encore : lancer preflight.sh avec --skip-cluster. Ce drapeau saute
les deux sections qui exigent un cluster, et elles seules : la joignabilité du cluster (6) et la
StorageClass par défaut (7). Le contrôle 8, la joignabilité des six endpoints de la couche de
données, tourne dans les deux cas : ses nc -z partent du poste vers des endpoints externes au
cluster, et c'est justement avant l'installation que cette réponse compte le plus.
Attendu, une fois la fiche remplie (page 03) : PREFLIGHT : tous les controles passent. Cette
ligne couvre bien les six endpoints de données : les six lignes ok du contrôle 8 sont dans la
sortie, et six KO s'y trouveraient tout autant.
Si une ligne affiche KO, le contrôle correspondant a échoué. Parmi les contrôles exécutés à
ce stade, chaque ligne KO bloque l'installation : elle ne se contourne pas, elle se corrige
avant de poursuivre. Une fois le cluster amorcé (page 06), relancer la même commande sans
--skip-cluster : elle ajoute les deux sections qui exigent le cluster, la joignabilité et la
StorageClass par défaut.